

A comunidade de código aberto está prosperando, especialmente nestes tempos em que a IA está em toda parte e exige uma quantidade cada vez maior de dados para seus modelos. Essa tendência levou a um aumento nas atividades de web scraping, mas também incentivou o desenvolvimento de medidas anti-bot mais avançadas. Com isso em mente, deixe-me compartilhar algumas das bibliotecas Python mais impressionantes para aproveitar a IA no web scraping e superar proteções anti-bot.
Pule a pilha de bibliotecas: use anti-bot bypass com 500 endpoints de biblioteca incluídos.
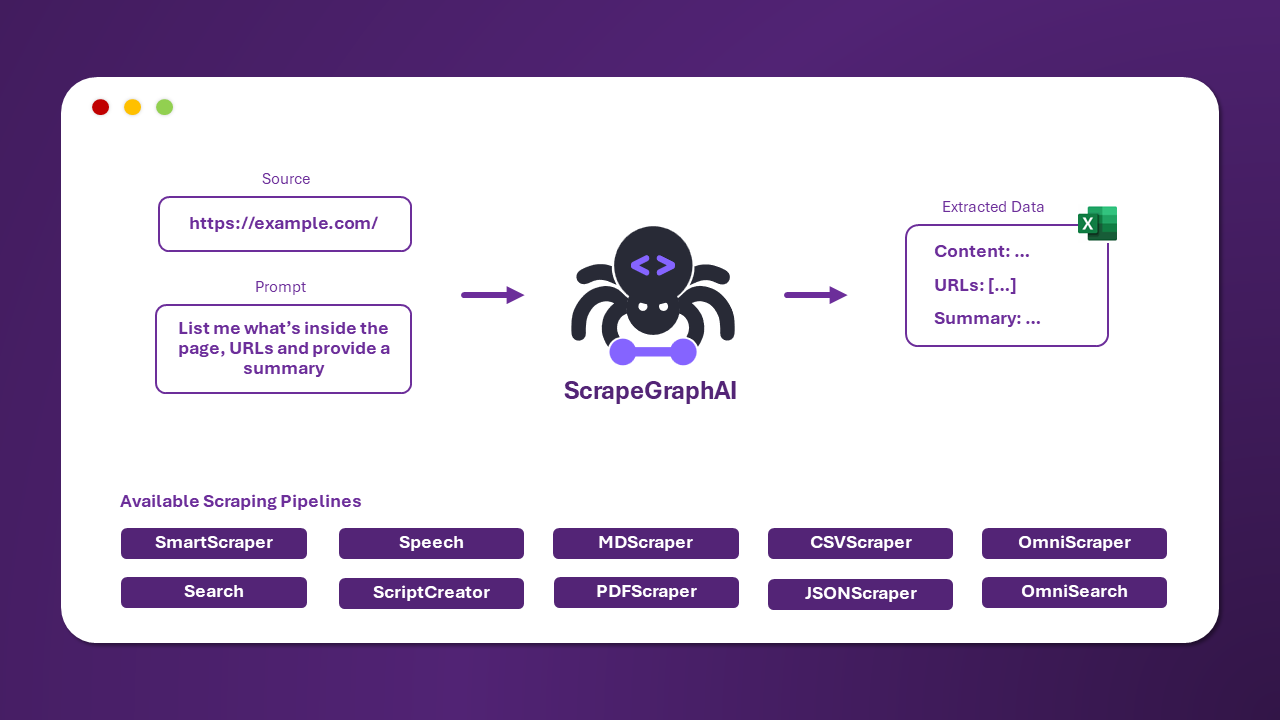
ScrapeGraphAI
Com o ScrapeGraphAI, você pode conectar seu LLM preferido (localmente ou online) e:
- Extrair dados de uma ou várias páginas definindo um esquema de dados alvo.
- Extrair dados de resultados de motores de busca.
- Gerar arquivos de áudio a partir de dados extraídos de sites.
- Escrever automaticamente código Python para seu raspador usando bibliotecas como BeautifulSoup.
Embora os LLMs estejam se tornando mais acessíveis e precisos, seus tempos de resposta ainda não são ideais para projetos de web scraping em nível de produção. O melhor uso dessa tecnologia no web scraping, na minha opinião, é para escrever e corrigir automaticamente o código do raspador, deixando a execução para os frameworks atuais. Eles também estão trabalhando na extração de dados de documentos locais, algo que estou ansioso para ver. Você pode acompanhar o progresso deles ingressando no servidor do Discord.
Scrapoxy
Você pode reconhecer Fabien Vauchelles, o criador do Scrapoxy, por suas palestras perspicazes sobre bots e tecnologias anti-bot em vários eventos e webinars de web scraping. O Scrapoxy é um poderoso agregador de proxies que permite gerenciar proxies de vários provedores, tanto gratuitos quanto comerciais.
O que diferencia o Scrapoxy é sua gestão inovadora de proxies de datacenter. Ao criar e rotacionar máquinas virtuais em diferentes provedores de nuvem, o Scrapoxy permite construir um pool quase infinito de IPs com largura de banda ilimitada. Além disso, não se limita apenas a essa funcionalidade; usando um único endpoint em seus raspadores, você pode misturar diferentes provedores e tipos de proxy, aprimorando ainda mais suas capacidades de scraping.
Botasaurus
Botasaurus é outro framework robusto que vale a pena explorar. Ele suporta a criação de raspadores headless e headful. Durante meus testes iniciais há alguns meses, o Botasaurus demonstrou sua capacidade de contornar a detecção pelo Cloudflare e outros sistemas anti-bot, embora tenha algumas limitações.
Ao executar um raspador headful a partir de um datacenter, o Botasaurus atualmente carece de opções avançadas para mascarar a impressão digital do seu navegador, o que pode levar a bloqueios. Apesar disso, é uma ferramenta para se manter no radar.
Nodriver
Nodriver é o sucessor do Undetected-Chromedriver, eliminando a necessidade de Selenium e webdrivers. É totalmente assíncrono, oferecendo uma ferramenta rápida para scraping que é otimizada nativamente para permanecer indetectável pela maioria das soluções anti-bot, tudo com apenas algumas linhas de código. Você também pode gerenciar diferentes perfis, fornecendo tudo o que precisa para seus raspadores. Além disso, inclui utilitários para pesquisa inteligente de elementos, gerenciamento de sessões e integração perfeita com instâncias existentes do undetected_chromedriver, tornando-o uma ferramenta versátil e poderosa para tarefas automatizadas na web.
Undetected Playwright
Undetected Playwright é um patch que você pode aplicar aos seus raspadores Playwright para melhorar sua indetectabilidade contra sistemas anti-bot. Vimos esse patch em ação em um artigo sobre técnicas de detecção de CDP, onde melhorou significativamente o desempenho de nossos raspadores ao contornar esses métodos anti-bot cada vez mais comuns.
Camoufox
Camoufox é um navegador atualmente em desenvolvimento que foi recentemente compartilhado em nosso servidor do Discord pelo seu autor. Parece muito promissor. Construído com base no Firefox, o autor removeu recursos desnecessários e adicionou mascaramento TLS, Browserforge para alterar a impressão digital do navegador e vários outros recursos. Testes realizados em sites conhecidos como o Browserscan parecem promissores, e estou ansioso para experimentá-lo.
